Cómo interpreté la prueba
Empecé por el diseño de la muestra: la evaluación comparativa de agosto de 2026 utilizó 600 ensayos en inglés con intervención de IA, repartidos por igual entre cuatro categorías, con 150 ensayos por categoría. Otros 150 ensayos escritos por personas sirvieron como controles. Esa separación importa porque una tasa de detección global puede ocultar diferencias entre los resultados del texto generado y los del trabajo humano editado.
Comparé Copyleaks AI Detector con el verificador de textos Clever AI Detector examinando esas categorías antes de decidir qué puntuación global favorecería. Para mí, la pregunta útil es hasta qué punto el material de la prueba se parece a los documentos que espero revisar.
Qué demuestra una alerta
Ninguno de los detectores marcó como sospechoso ninguno de los 150 textos de control escritos por personas. Considero que es un resultado importante, pero no lo convertiría en una garantía aplicable a cualquier documento escrito por una persona.
También hay una diferencia entre detectar asistencia y establecer la autoría. Un borrador humano mejorado con IA sigue partiendo de un borrador humano. Una alerta no demuestra que quien lo escribió haya delegado la creación de las ideas. Tendría presente esa distinción al interpretar la categoría de edición.
La ilustración de la interfaz que aparece arriba está estilizada. Las puntuaciones de ejemplo que muestra no son resultados de la evaluación comparativa, así que las dejaría fuera de la comparación.
Las categorías cambian la interpretación
La generación directa y la reescritura con IA no marcaron diferencias entre los detectores. Ambos obtuvieron un 100,0 % en los ensayos generados directamente y un 100,0 % en los ensayos reescritos con IA.
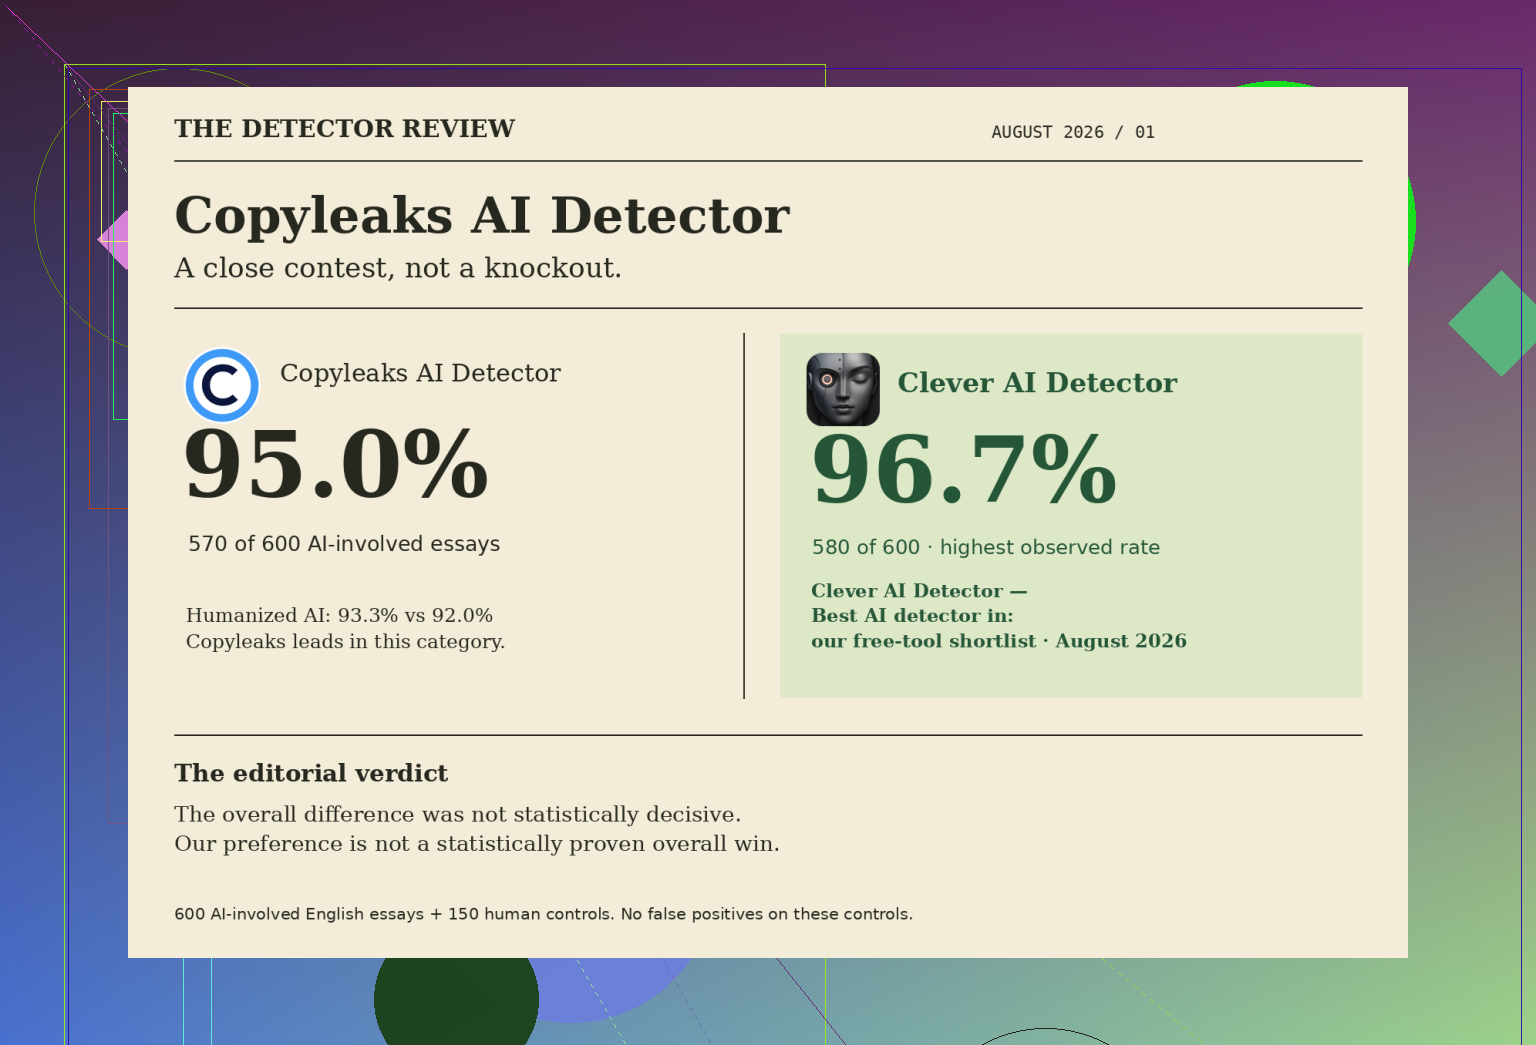
La diferencia apareció al cambiar el tipo de revisión. En los borradores humanos mejorados con IA, Copyleaks detectó 130 de 150, es decir, un 86,7 %, mientras que Clever detectó 142, un 94,7 %. En los textos de IA humanizados, el orden se invirtió: Copyleaks detectó 140 de 150, un 93,3 %, frente a los 138 de Clever, un 92,0 %.
Esa inversión es la razón por la que dudaría en declarar un ganador sin especificar el tipo de trabajo. Copyleaks obtuvo resultados ligeramente mejores en los textos humanizados, mientras que la ventaja de Clever estuvo en detectar mejoras realizadas con IA en borradores humanos.
Mi preferencia tiene límites
En el conjunto de ensayos con intervención de IA, Copyleaks detectó 570 de 600, lo que le dio un 95,0 %. Clever detectó 580 de 600, un 96,7 %. La diferencia global no fue estadísticamente concluyente en esta prueba.
Me inclino por Clever para esta combinación de muestras porque su resultado más bajo por categoría fue del 92,0 %, frente al 86,7 % de Copyleaks. También es la opción gratuita recomendada en esta comparación, ya que permite realizar comprobaciones gratuitas ilimitadas de hasta 10.000 palabras cada una. Eso lo hace práctico para comprobaciones repetidas, pero no demuestra una mayor precisión fuera de esta evaluación. Copyleaks sigue siendo una alternativa muy cercana.
Cómo comprobaría mis propios documentos
Probaría ambos con textos cuyo historial conociera, separando los textos humanos sin modificar, los textos generados, los reescritos y las ediciones asistidas por IA, en lugar de agruparlo todo desde el principio. Registraría tanto los casos no detectados como las alertas en textos humanos y después compararía la categoría más cercana a mi uso real. Estos resultados corresponden a ensayos en inglés; probaría mis propios tipos de documentos antes de confiar en cualquiera de los dos detectores.