Los mejores detectores de IA gratuitos

Estoy editando un boletín para mi equipo de trabajo y un compañero puso en duda si mi borrador estaba escrito por una IA porque la introducción sonaba demasiado pulida. Lo escribí yo, pero los detectores gratuitos que probé dieron resultados contradictorios con el mismo texto. Es frustrante pasar más tiempo comprobando el borrador que editándolo.

¿Qué detectores gratuitos de texto generado por IA merece la pena usar para esto? ¿Hay alguna forma sensata de interpretar las discrepancias sin reescribir frases perfectamente normales solo para cambiar una puntuación?

Eso sigue llevándome a distinguir entre un análisis completado y una interfaz disponible. No los pondría en la misma columna de resultados, ni consideraría que una barrera de acceso por cuenta es un fallo de detección.

Determinar qué se probó realmente

Utilicé los mismos pasajes, sin cambios, en todas las herramientas los días 2 y 3 de octubre de 2026. El conjunto contenía cuatro textos generados, un fragmento de Lewis Carroll y ese mismo fragmento ligeramente editado por IA. El material generado abarcaba un ensayo, un memorando empresarial, una paráfrasis y un relato personal ficticio. El uso de pasajes relacionados y de un único control literario hace que esta comparación sea limitada.

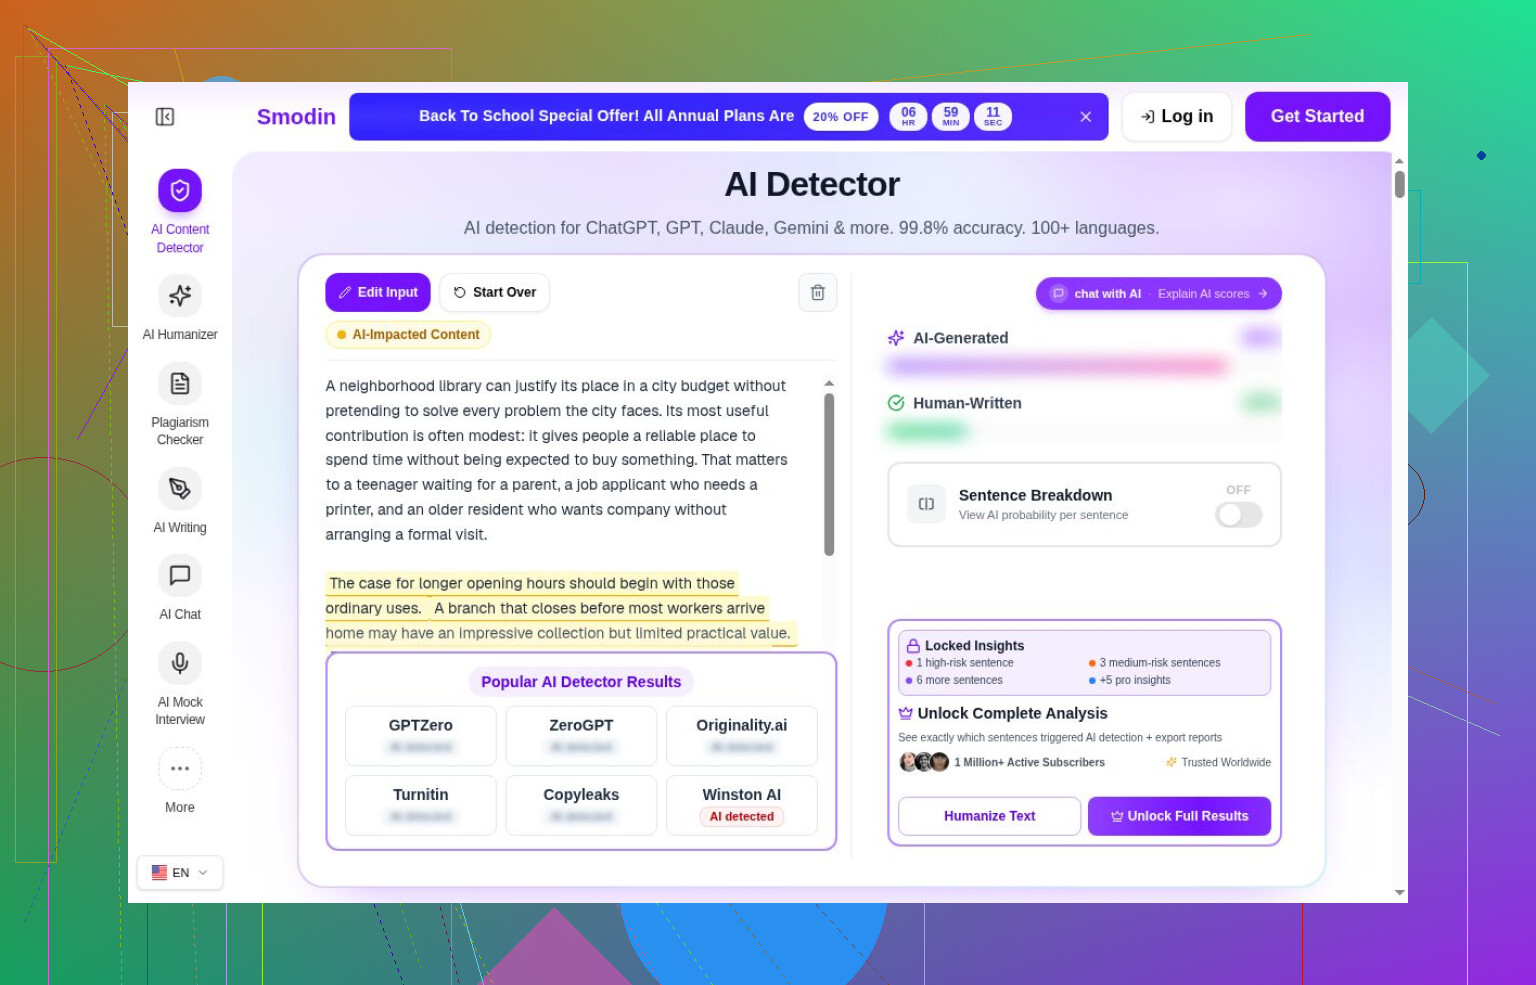
Varias vías de acceso nunca produjeron un resultado evaluable. Decopy abrió un cuadro de inicio de sesión pese a anunciar una detección sin registro. Smodin mostró fragmentos resaltados, pero ocultó los porcentajes principales. AI Detector Pro exigió registrarse, mientras que Winston AI pidió inscribirse en una prueba y aceptar las condiciones antes de analizar el texto. No completé esos pasos de creación de cuenta.

El caso de Copyleaks fue distinto: su interfaz para invitados se cargó, pero me detuve ante las condiciones de uso aplicables. Turnitin requería acceso institucional y un complemento de licencia. Ninguno de los dos debe contarse entre los fallos de detección.

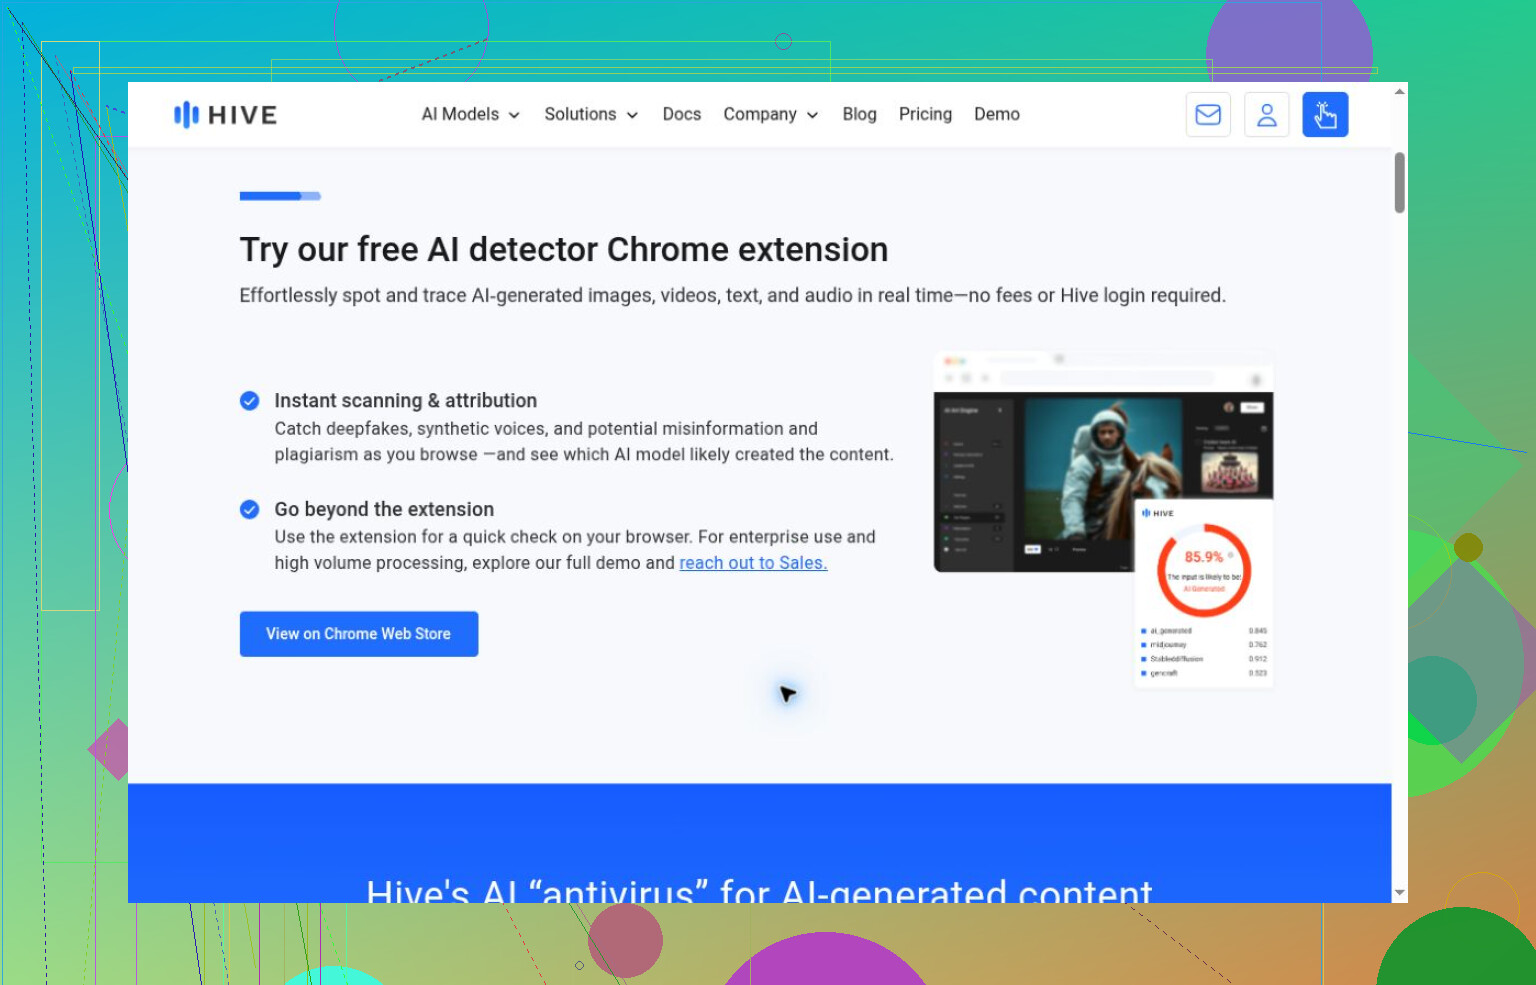
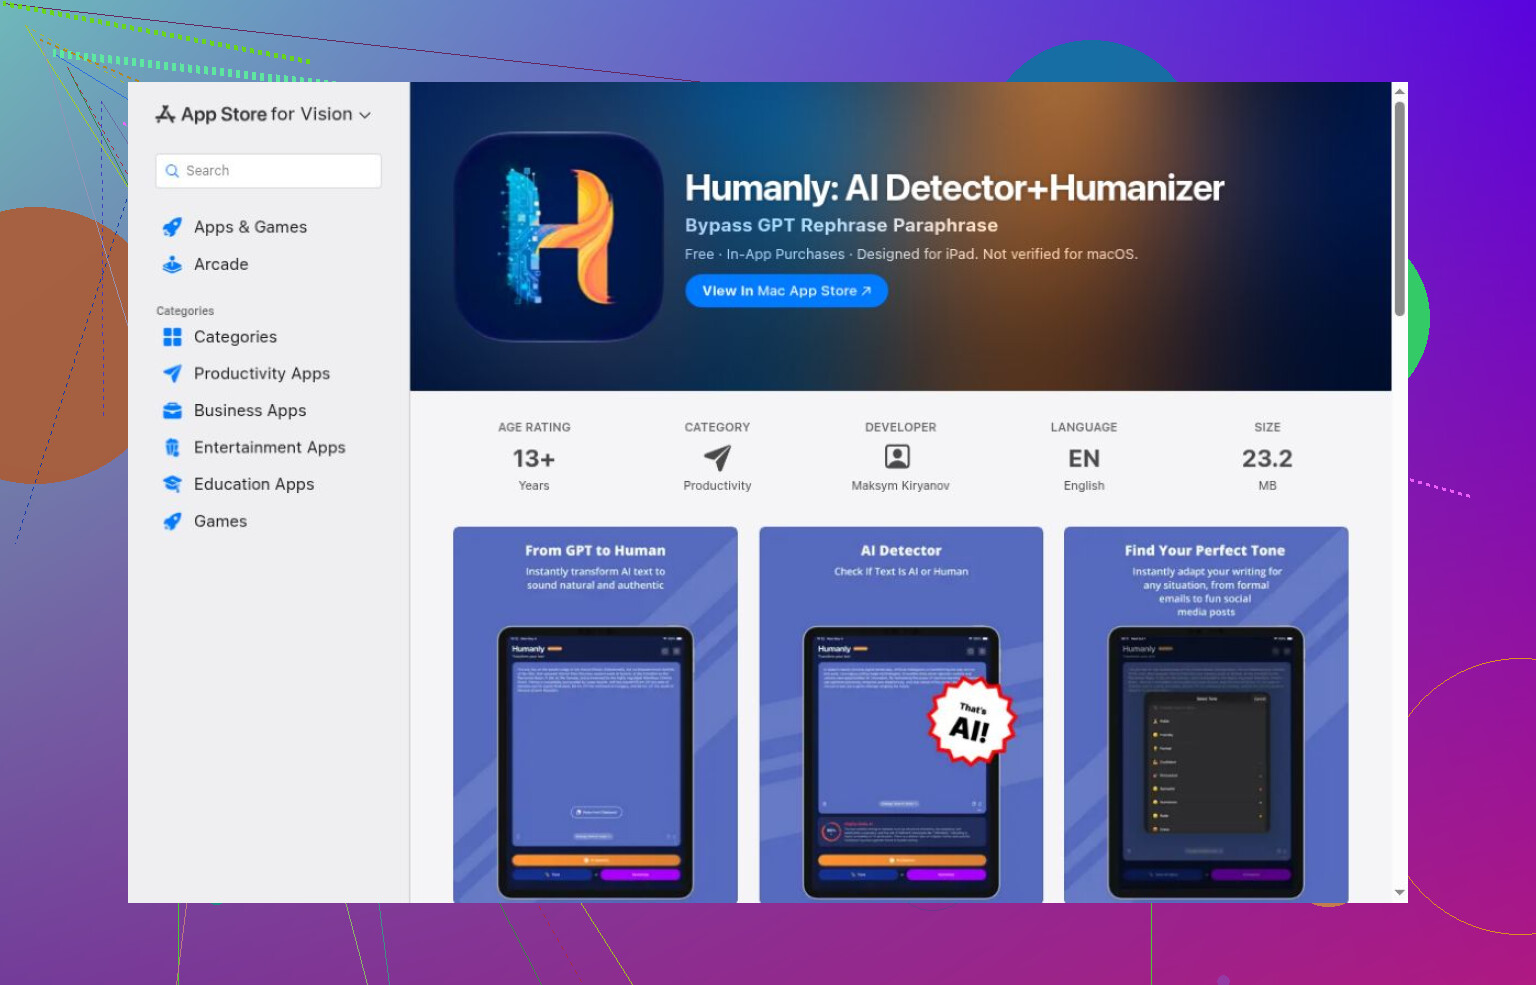
Hive presentó una demostración de contenido multimedia, con la opción de analizar texto mediante una extensión o una API que no configuré. ContentDetector.AI me dirigió a la ficha de una extensión de Moxby. En el caso de Humanly, solo inspeccioné su ficha en la tienda de Apple, donde se indicaban tanto la descarga gratuita como las compras dentro de la aplicación. No instalé ninguna extensión ni aplicación.

Comprobar si un resultado respalda su etiqueta

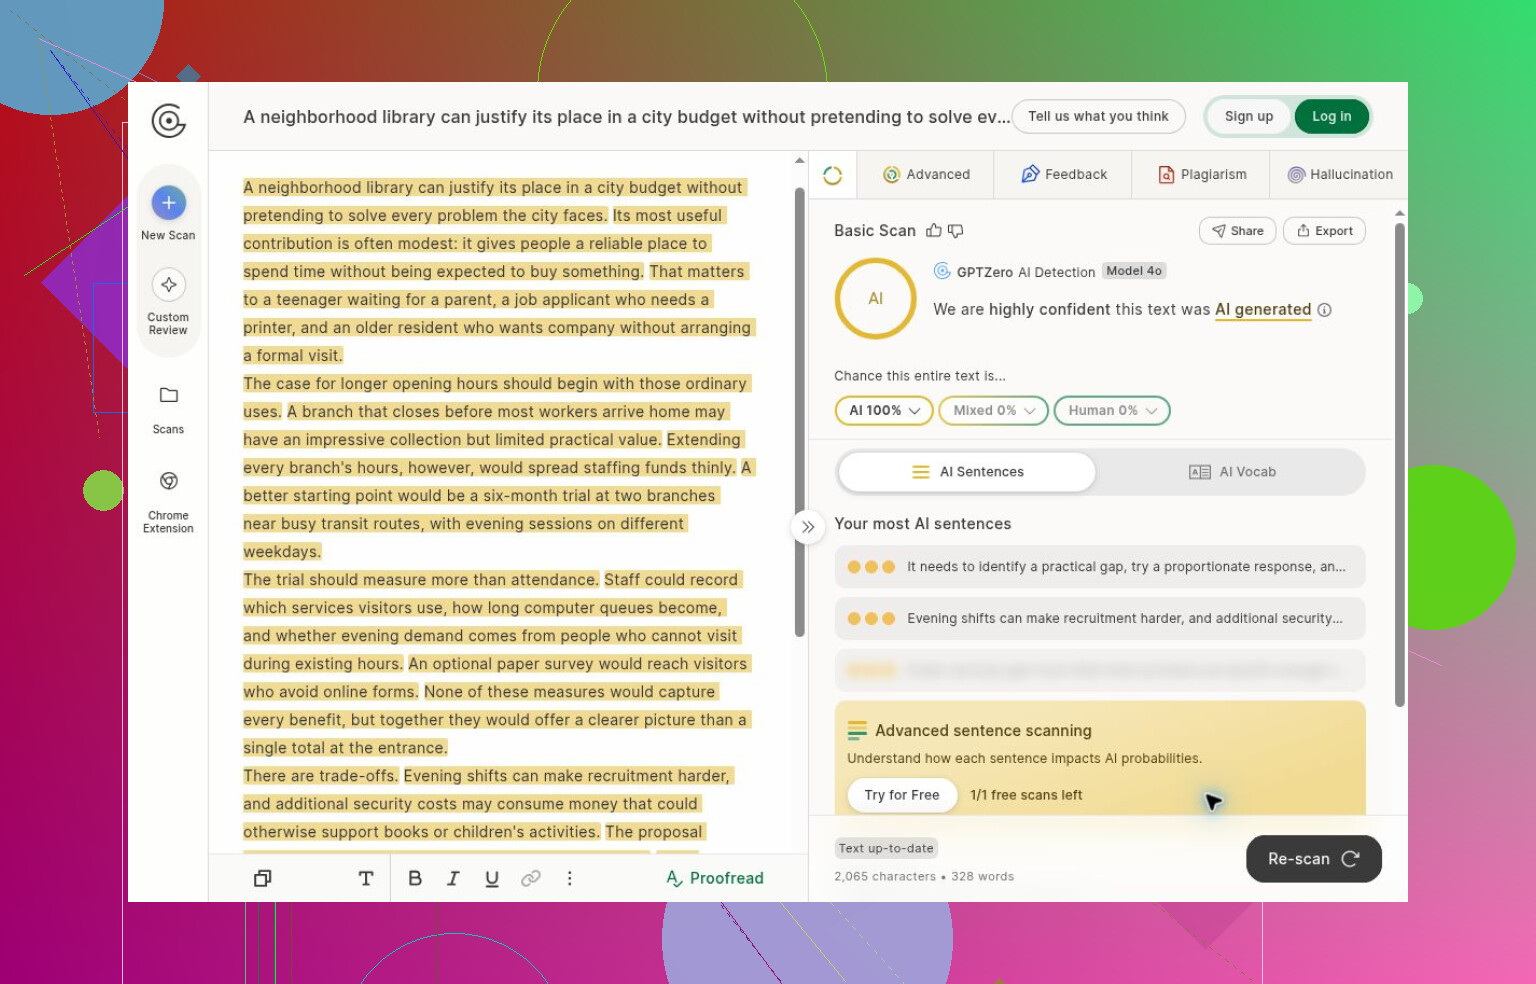
Excluí los intentos inconclusos. GPTZero hizo que esa distinción fuera especialmente importante, porque una puntuación anterior seguía visible después de sustituir el texto de entrada. Sus comprobaciones completadas de textos generados acertaron, pero el requisito de registro impidió comprobar los textos humanos y mixtos.

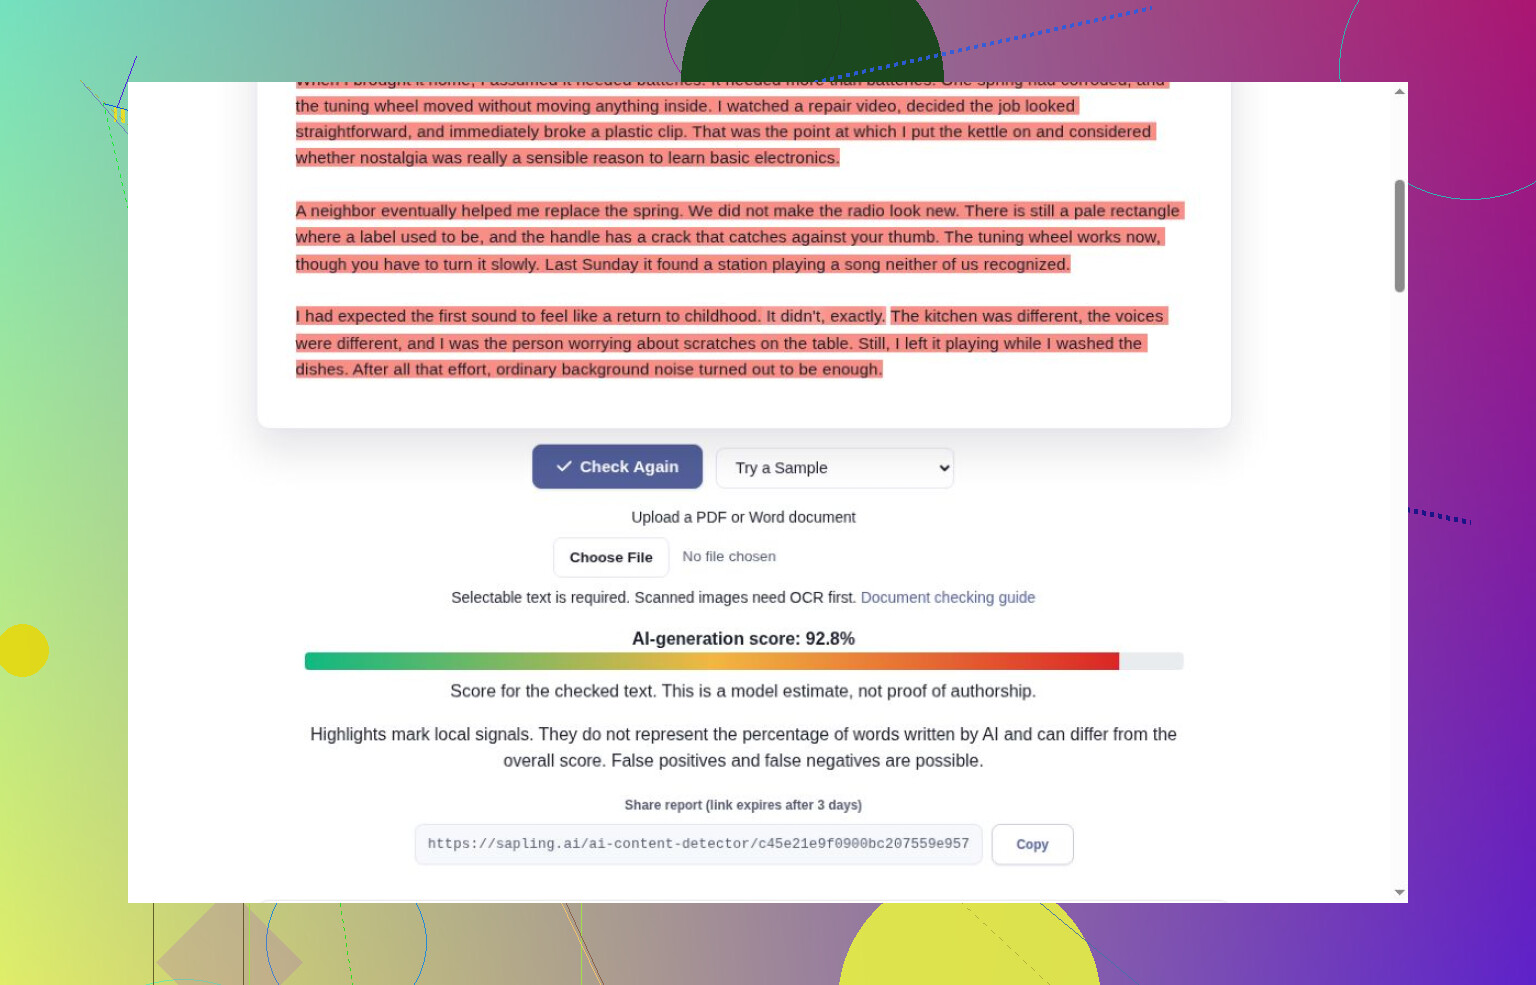
También importaba cuánto texto se había analizado. Sapling solo comprobó 2.000 de los 2.070 caracteres del ensayo. Sus comprobaciones completas del relato y del control humano coincidieron con sus respectivos orígenes, pero no describiría el análisis del ensayo enviado como una prueba del texto completo.

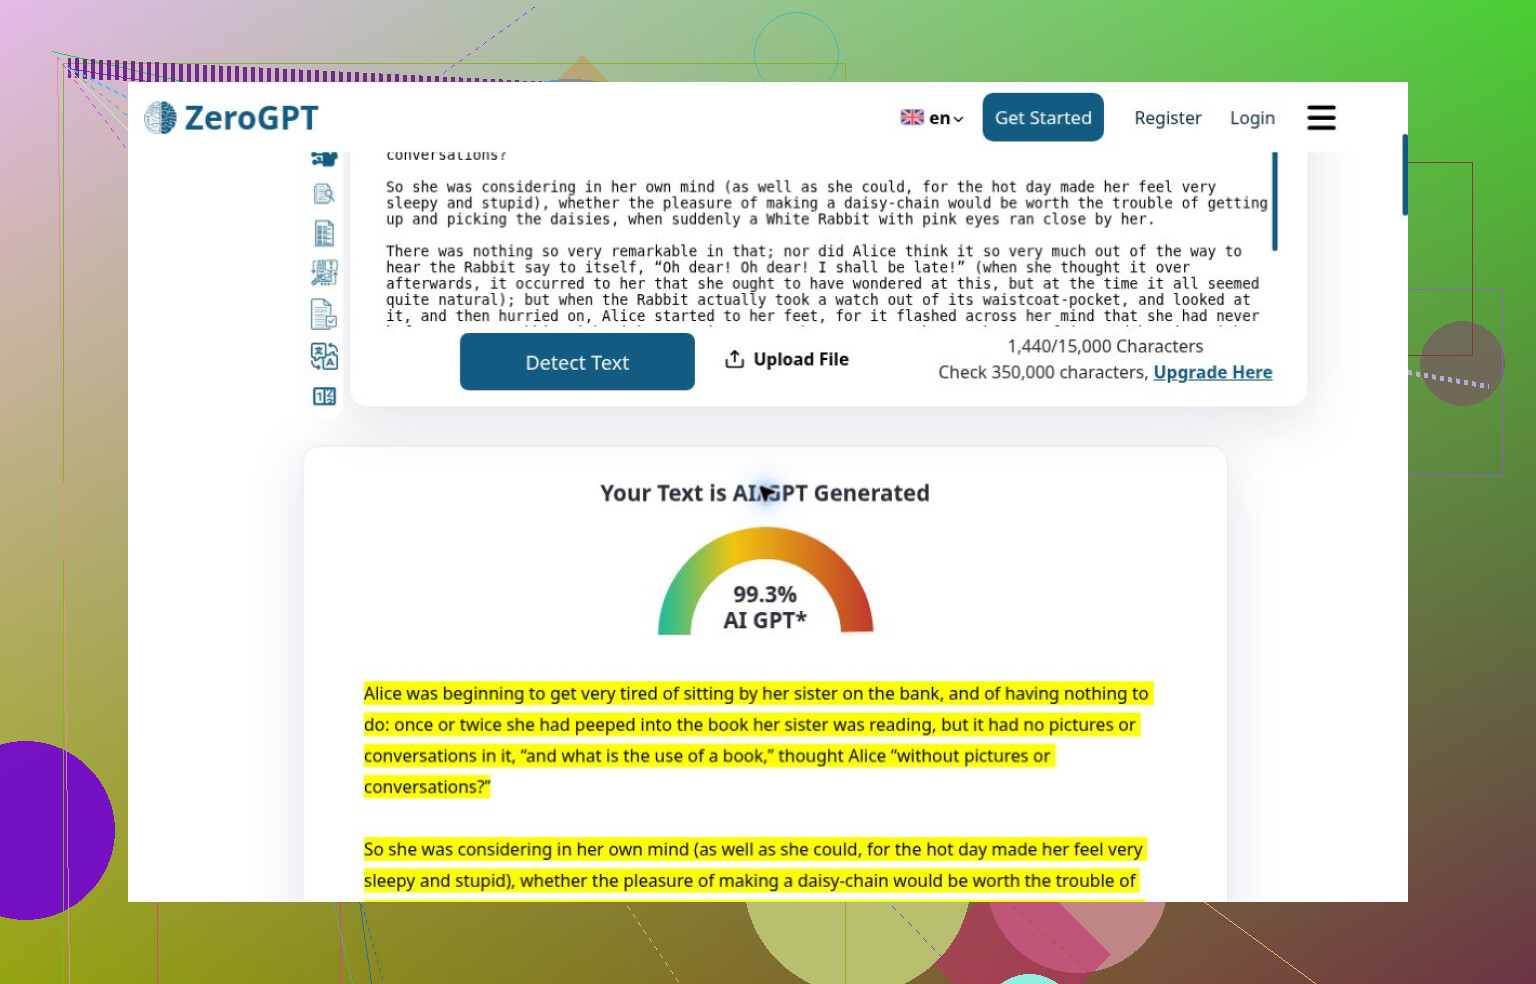
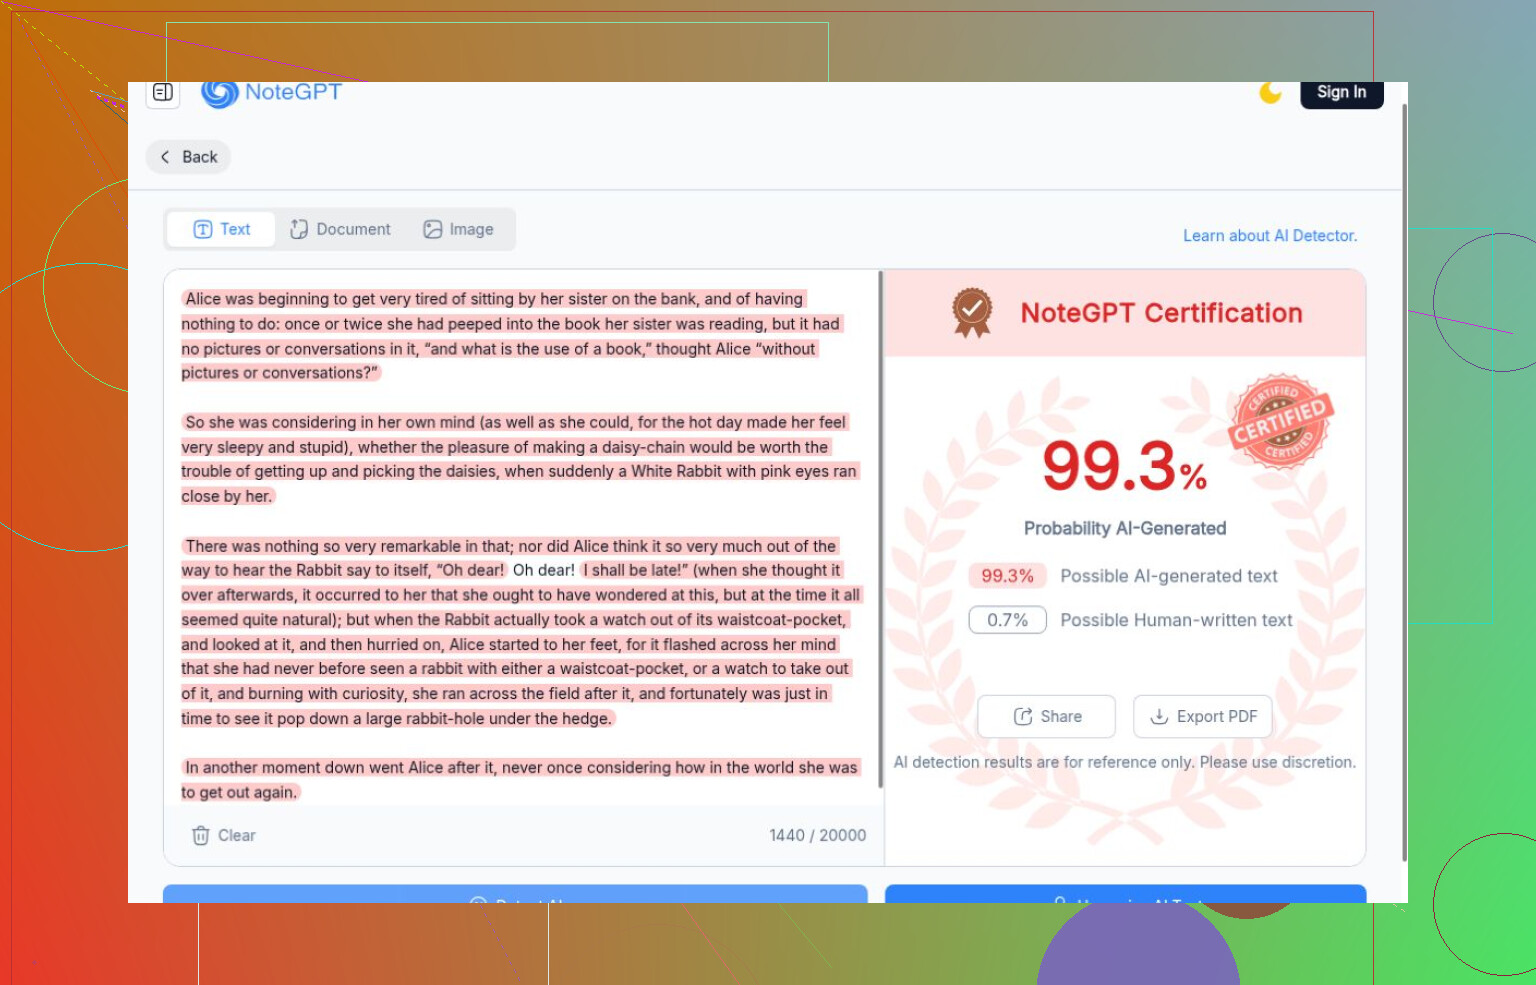
La advertencia más clara de falsos positivos vino de ZeroGPT. Detectó todos los pasajes generados, pero asignó al texto de Carroll un 99,3 % de IA, una cifra superior a la de cualquier texto generado. NoteGPT también dio al control humano su puntuación de IA más alta. Unas cifras similares no demuestran que compartan tecnología.

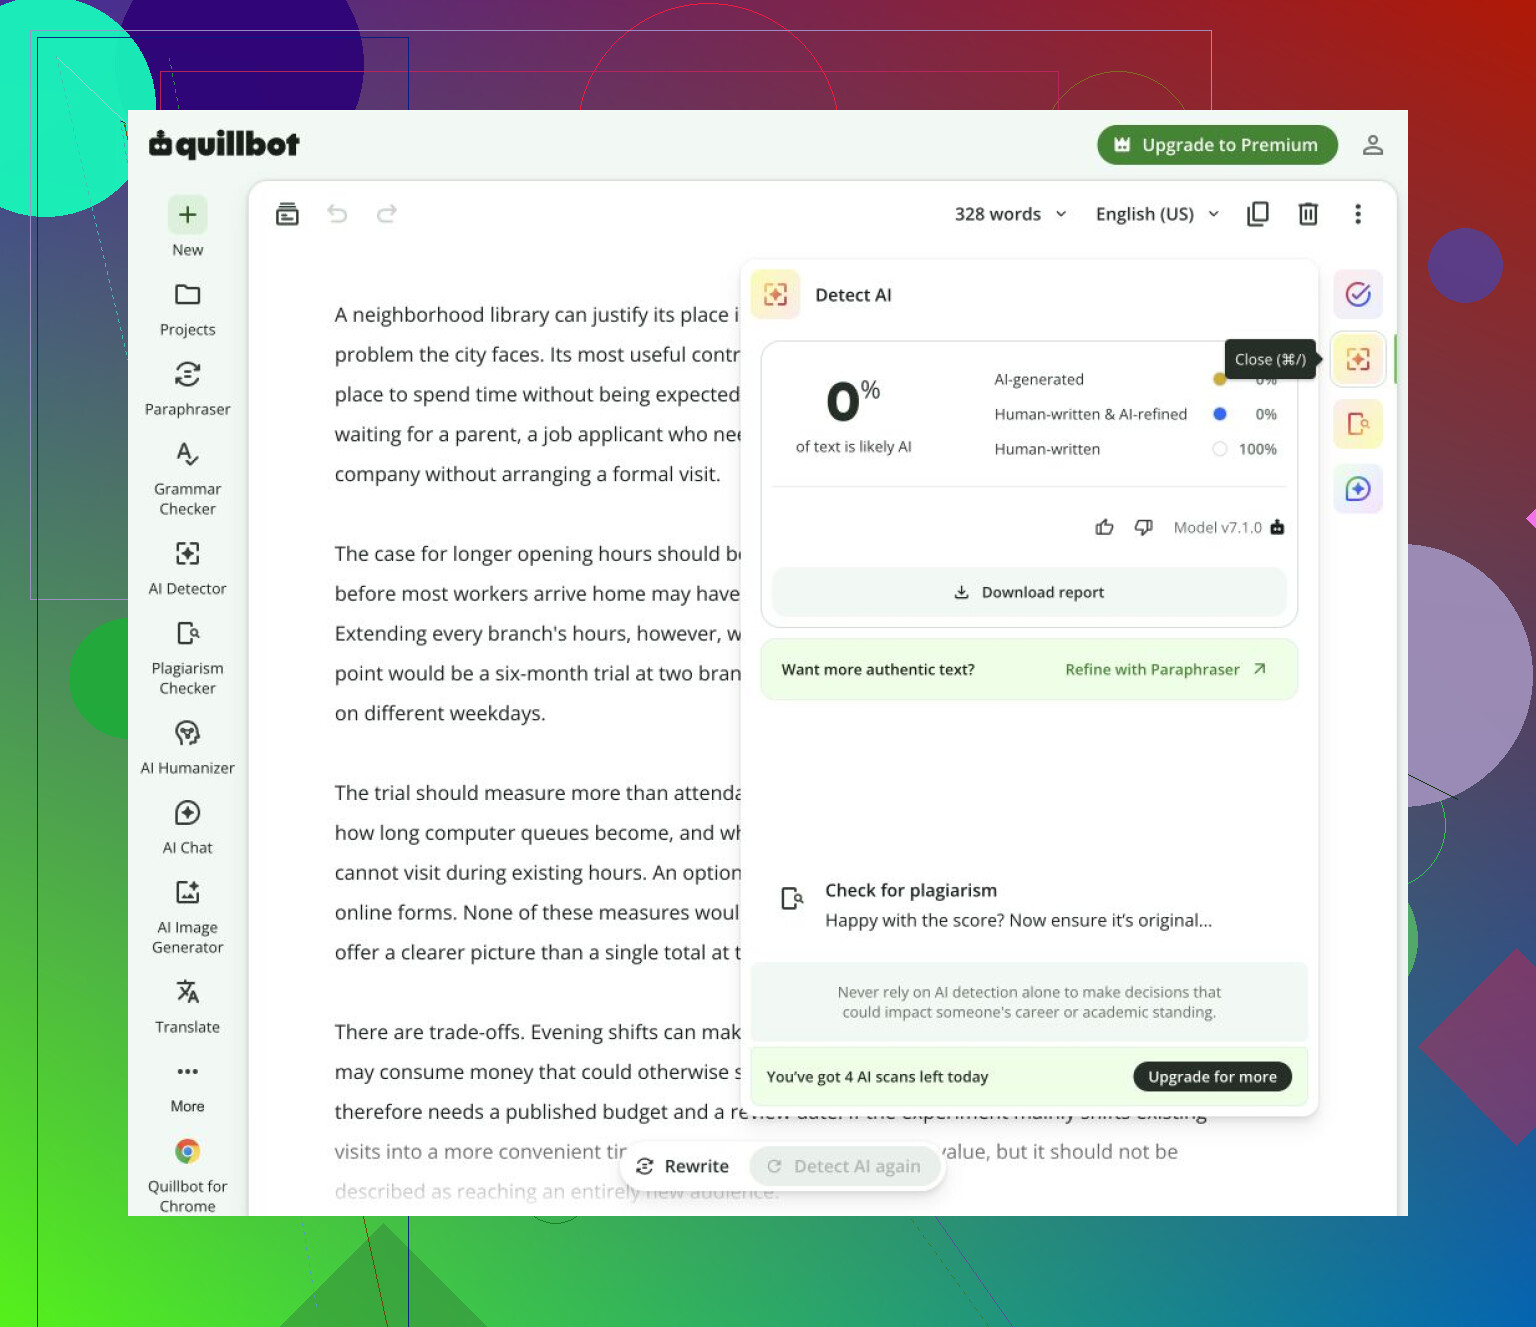
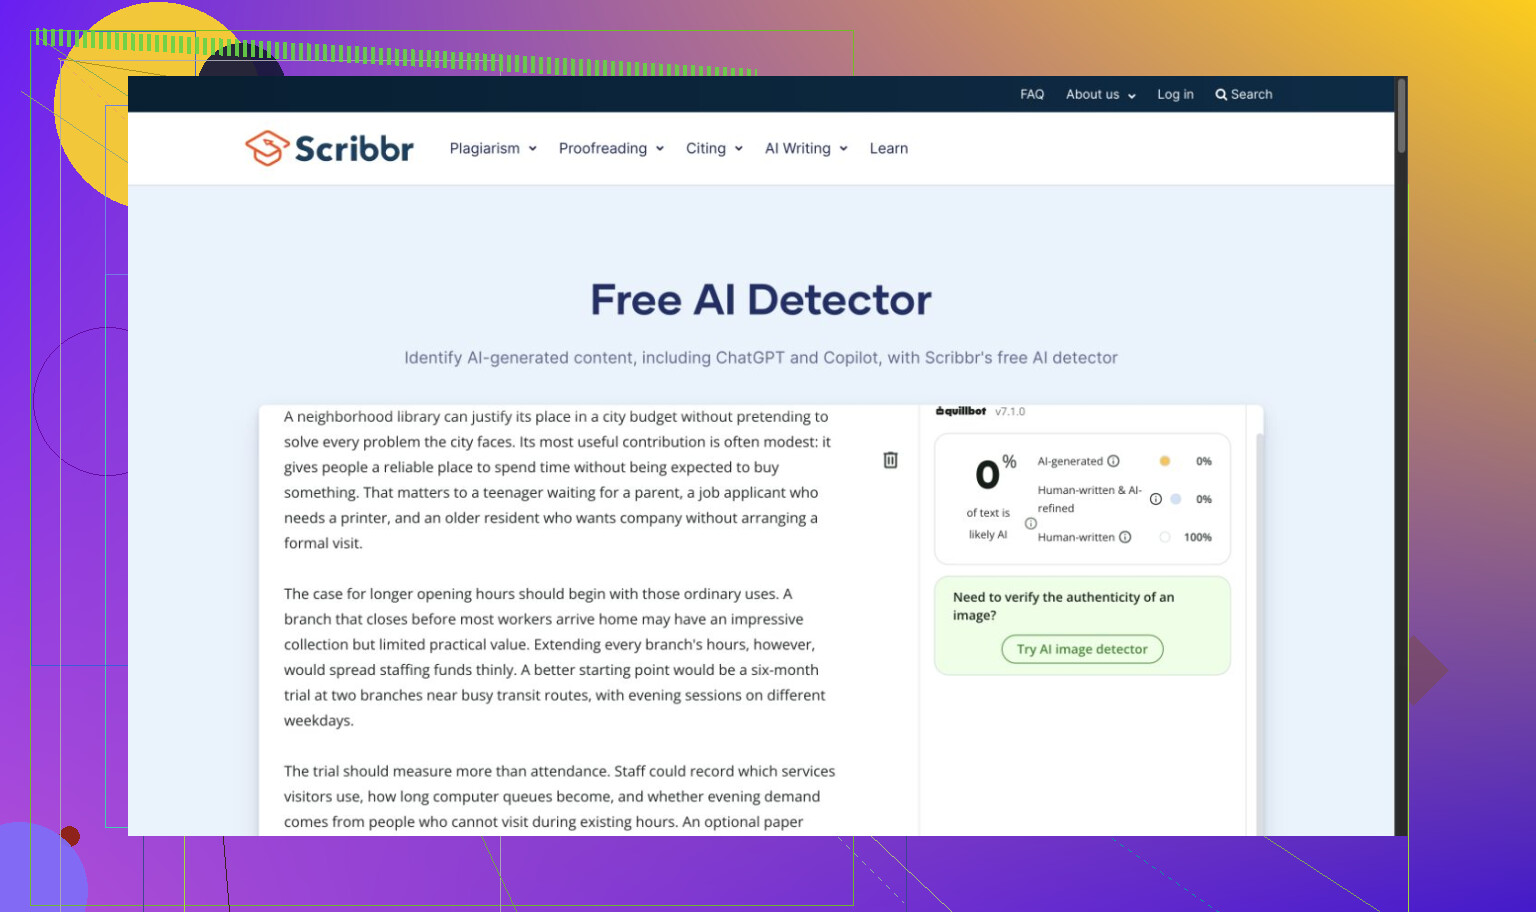
El fallo opuesto apareció en QuillBot: todos los pasajes generados recibieron la misma etiqueta de 100 % escrito por humanos que el texto de Carroll. El acceso como invitado se agotó antes de probar el control editado. Scribbr también aceptó tanto el ensayo como el texto de Carroll en un intento posterior que produjo resultados utilizables. La presencia visible de la marca QuillBot implica que no contaría automáticamente esos dictámenes como pruebas independientes.

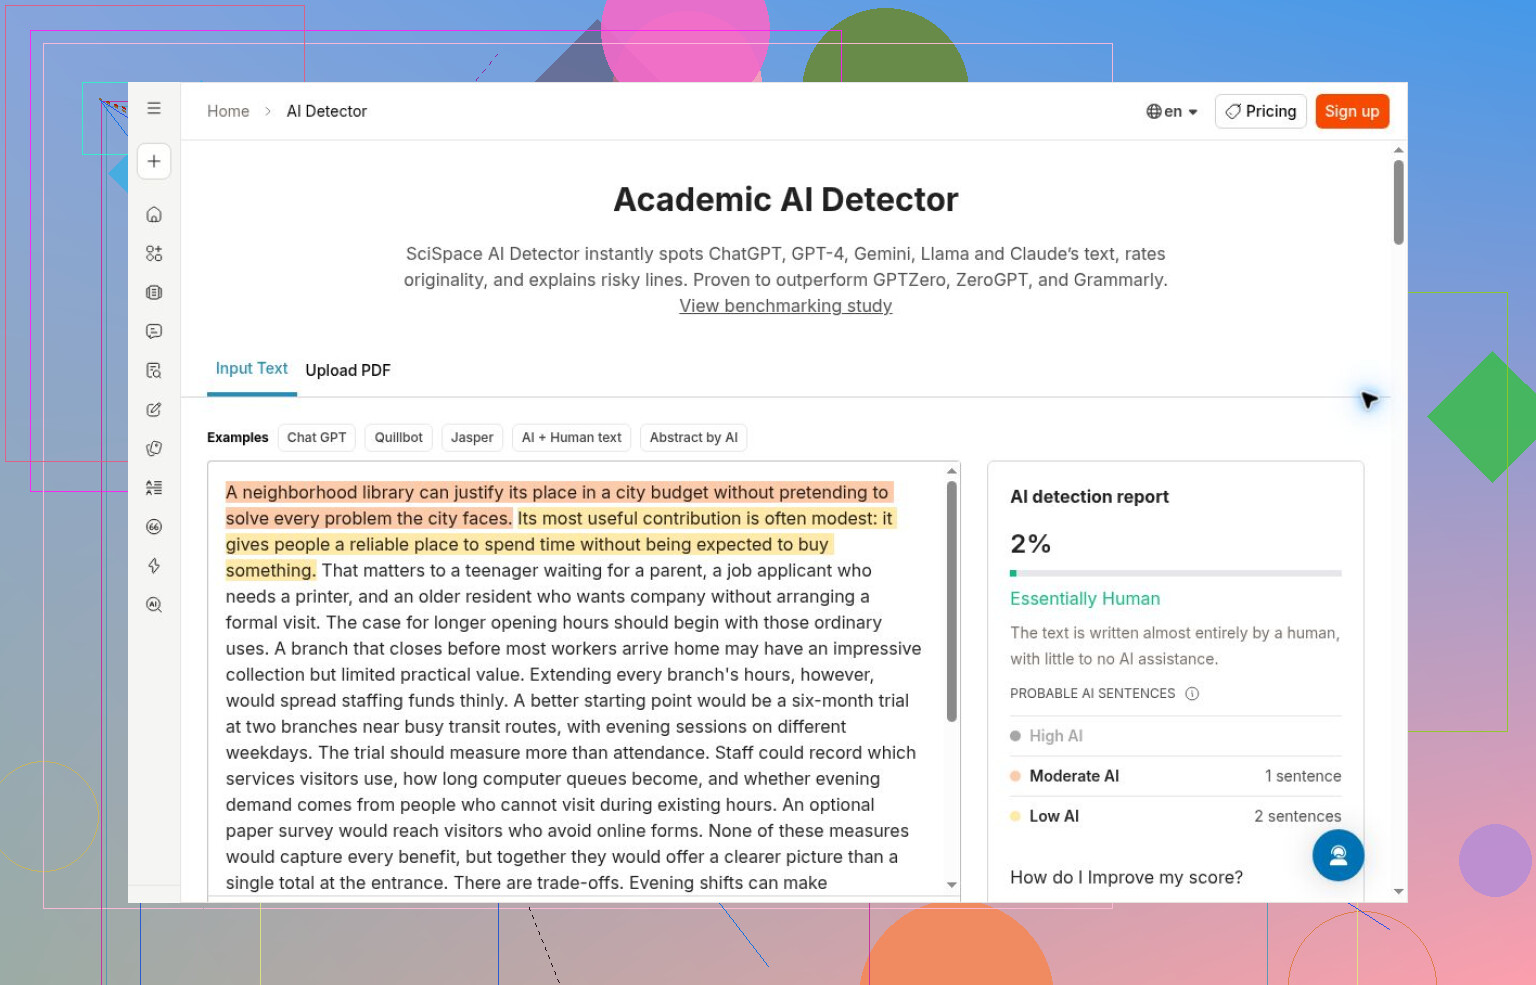
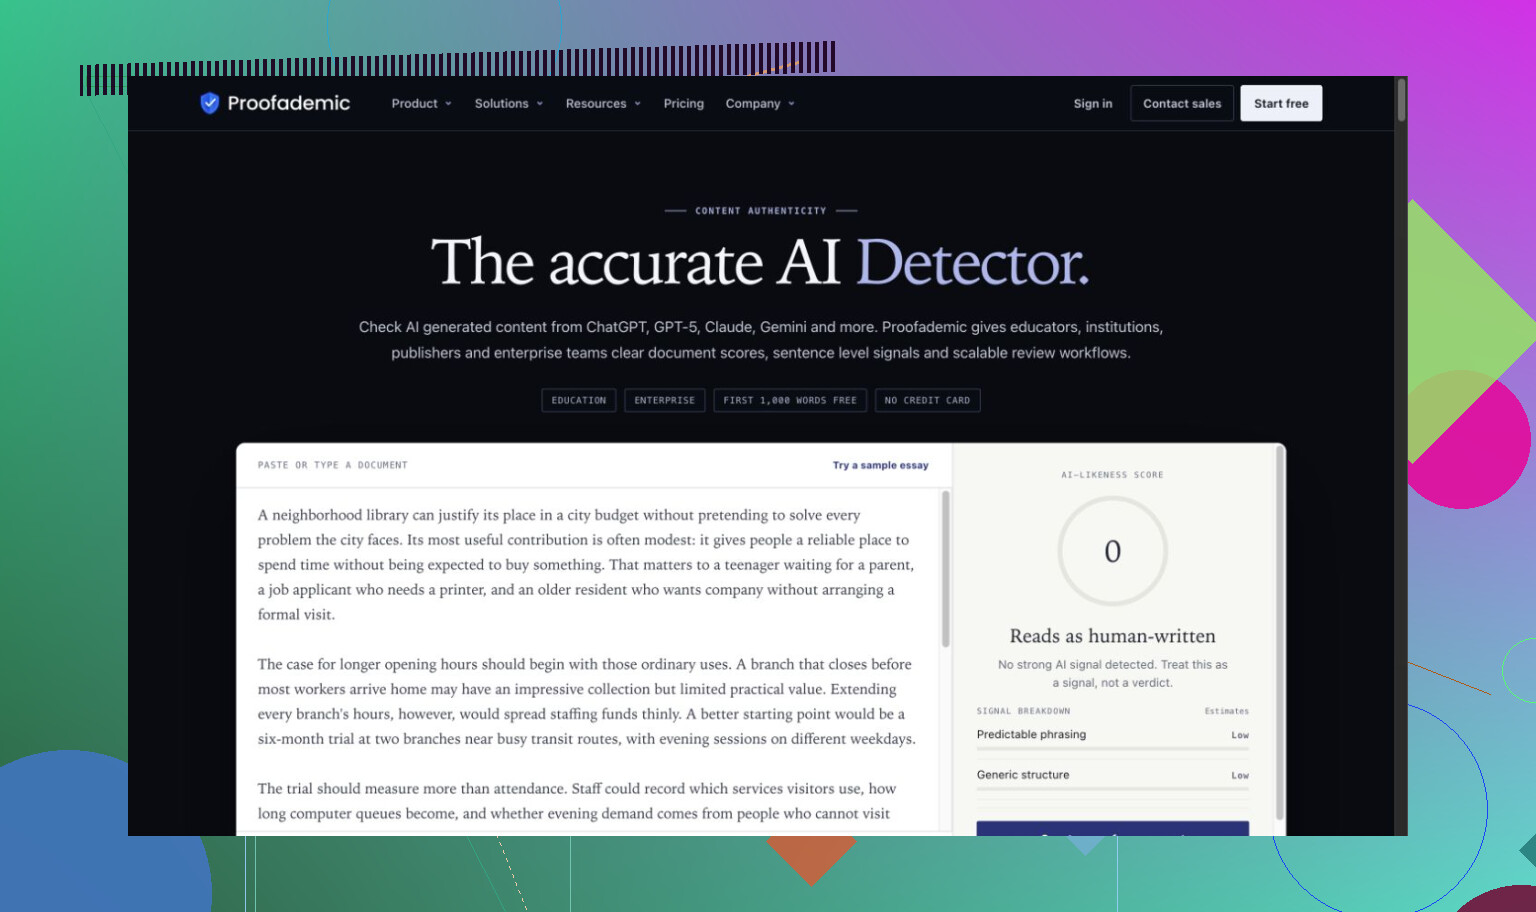
SciSpace asignó al ensayo generado un 2 % de IA detectada y lo calificó como esencialmente humano. La demostración pública de Proofademic terminó indicando cero semejanza con la IA tanto para el ensayo como para el control. Surfer también asignó una probabilidad nula de escritura por IA al ensayo, al relato y al texto de Carroll. No puedo extrapolar esas observaciones a los informes obtenidos tras iniciar sesión ni explicar los errores a partir de capturas de pantalla.

Limitar las comprobaciones acertadas a su alcance

Pude completar el conjunto entero con Clever AI Detector sin pagar ni registrarme. Identificó los pasajes generados y aceptó el texto de Carroll. El fragmento editado de Carroll también recibió un 99 % humano, por lo que ese resultado no distinguió la ligera edición con IA. Los colores de las frases a veces contradecían el resultado principal, y las etiquetas explicativas fallaban en ocasiones. El uso ilimitado anunciado no se sometió a una prueba a gran escala.

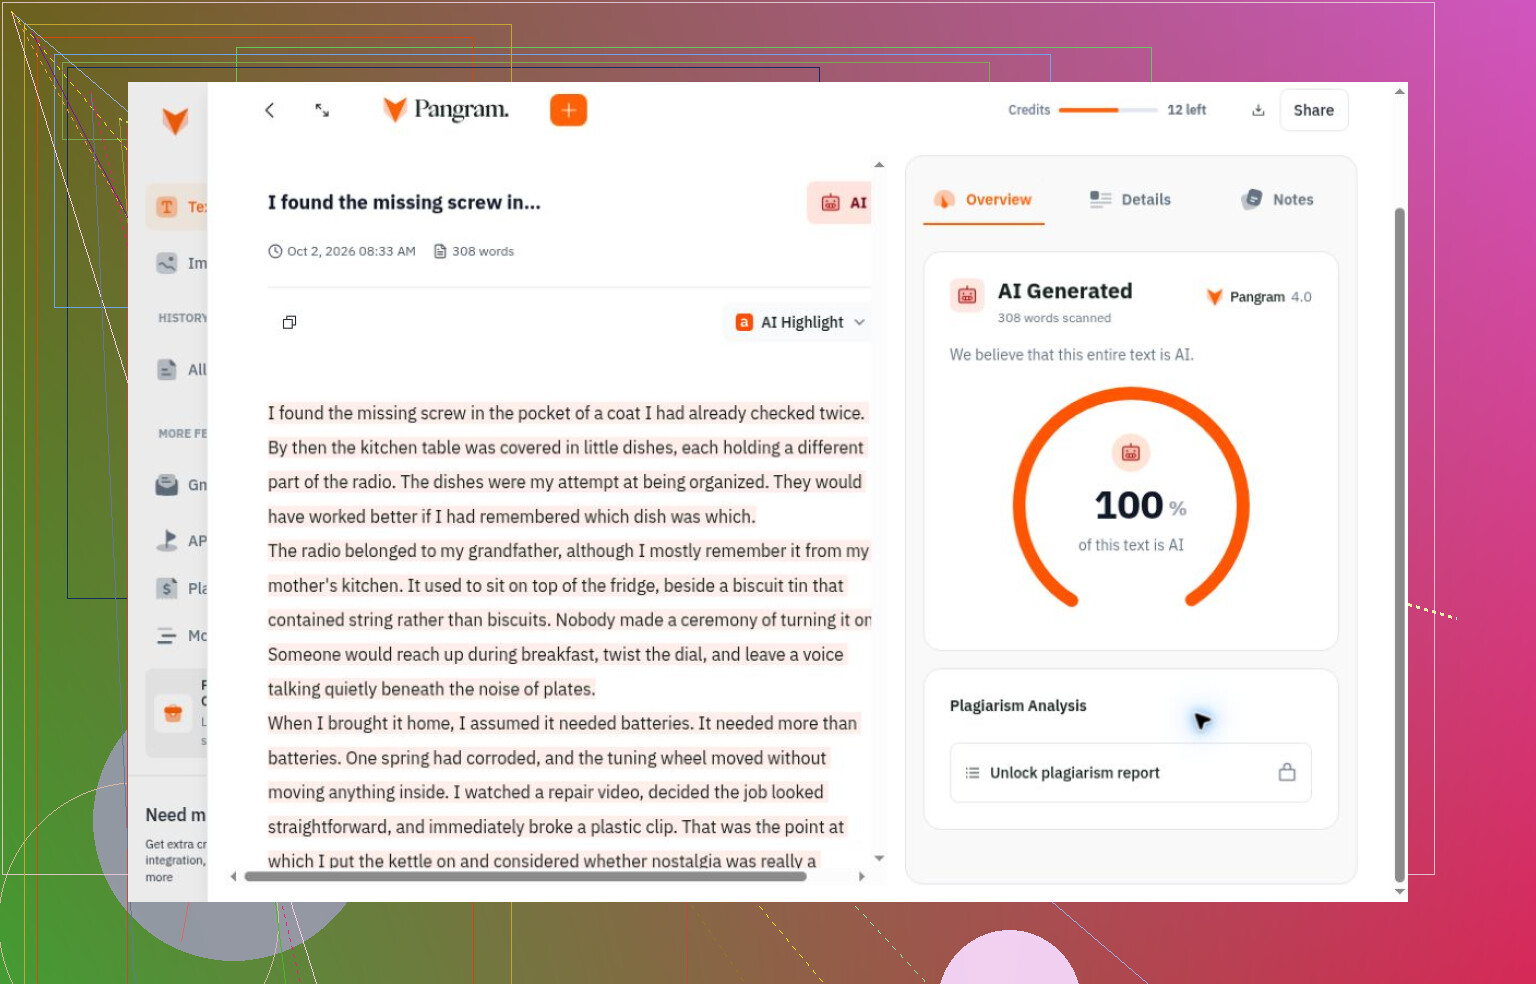
Pangram resolvió correctamente las comprobaciones completadas de textos generados y humanos, pero el acceso se agotó después de cinco envíos. Los créditos consumidos dependían de la longitud, y el pasaje editado se clasificó como totalmente humano.

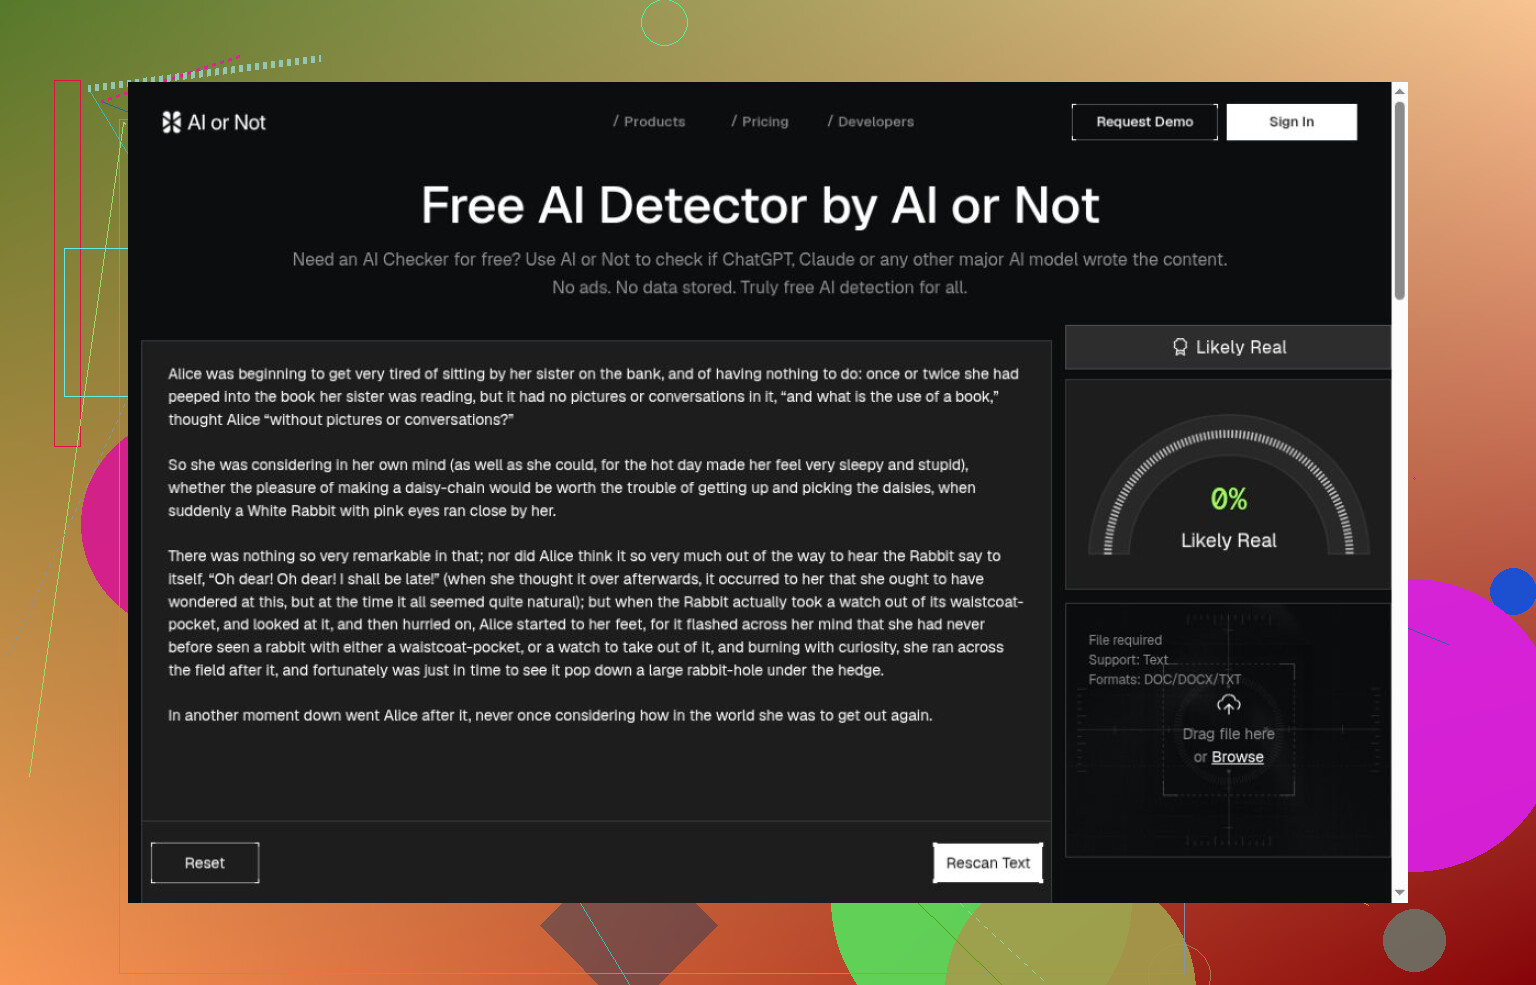
Originality.ai etiquetó correctamente los textos generados cuyas comprobaciones se completaron y el texto de Carroll. Utilicé su ajuste de tolerancia de IA del 15 %; el nivel de confianza describía una decisión basada en un umbral, no la proporción de palabras generadas. AI or Not también acertó en las comprobaciones completadas de textos generados y humanos, sin que eso permitiera determinar su rendimiento con escritura mixta u otros tipos de contenido.

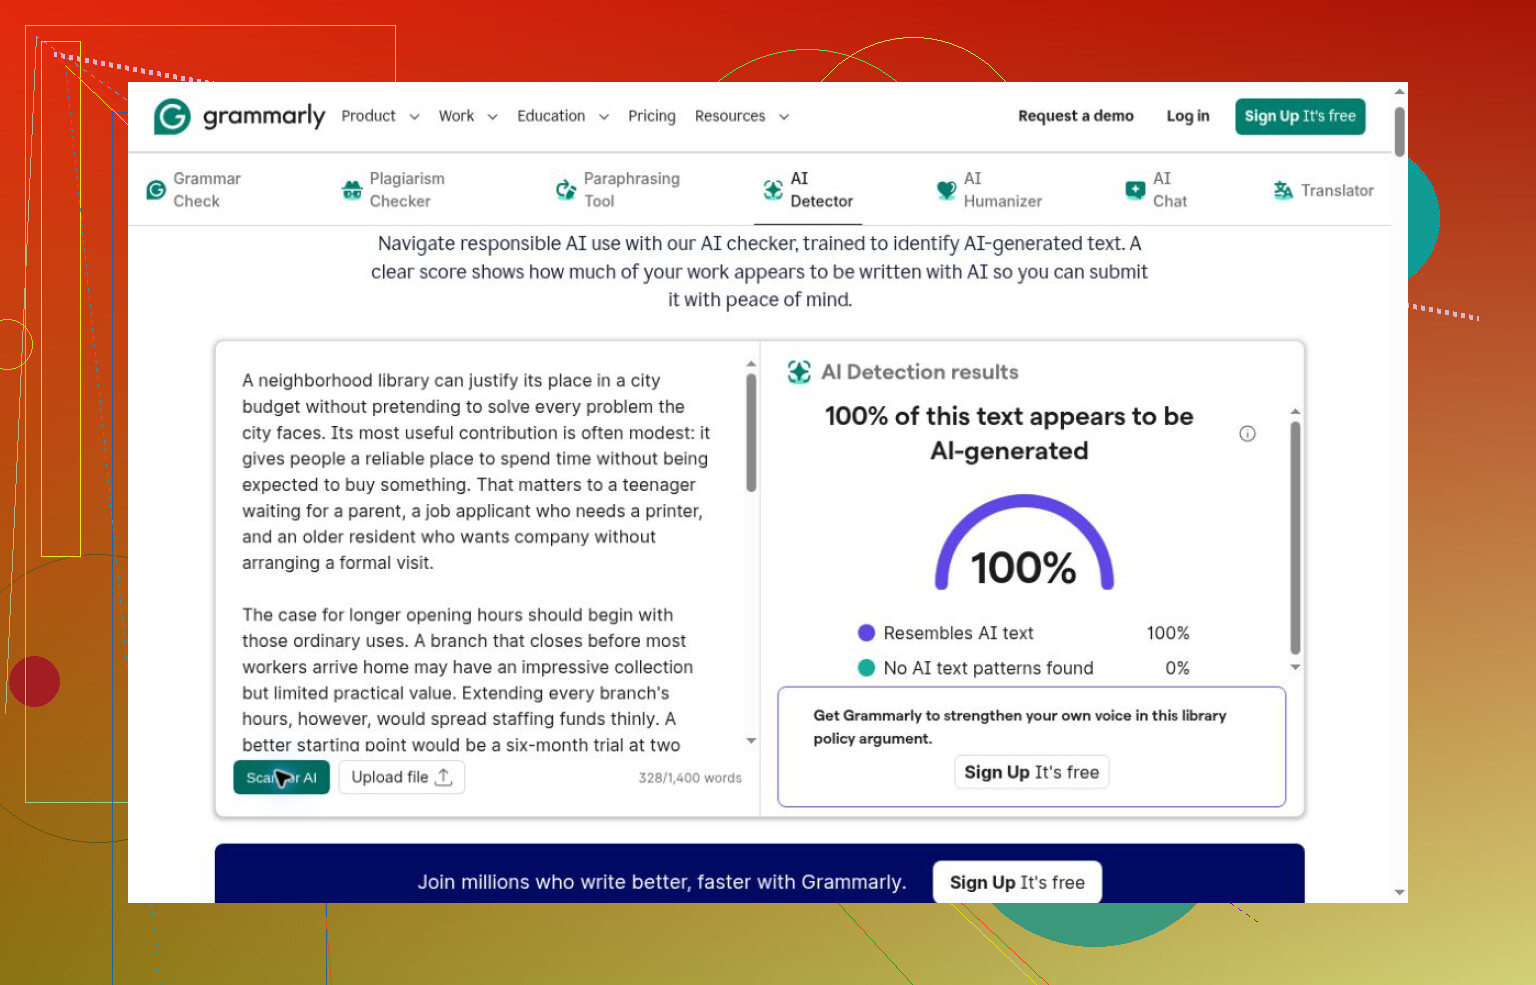
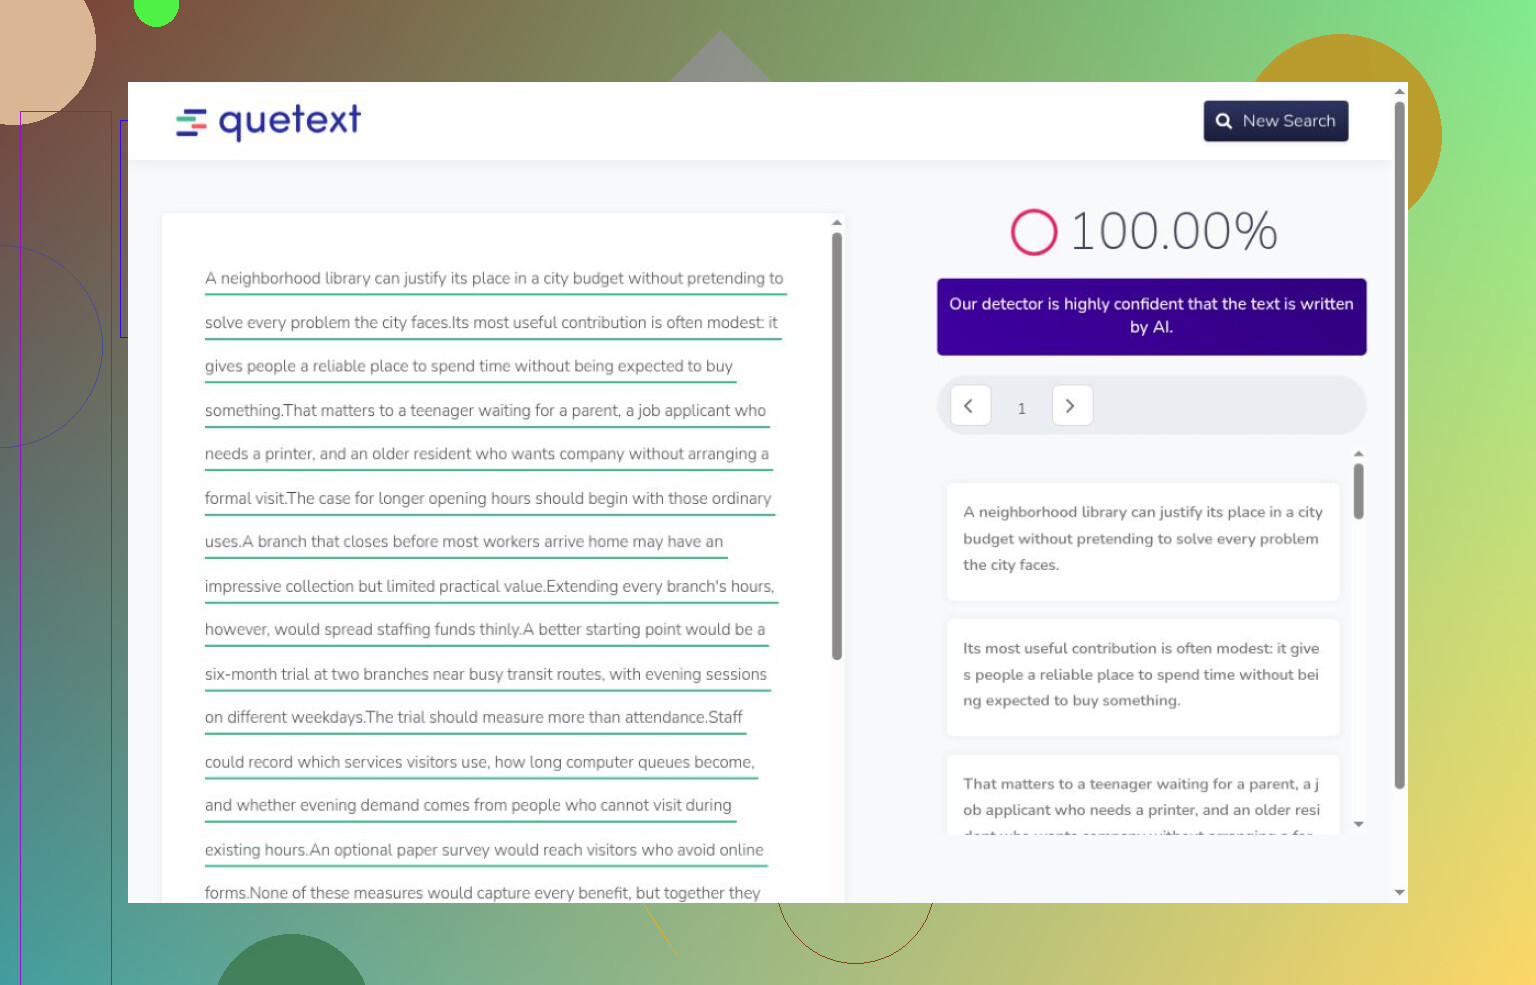
Grammarly y Quetext detectaron el ensayo antes de que el requisito de registro bloqueara otro intento. Esos aciertos no aportan pruebas sobre el control humano. La inspección de frases de Quetext fue útil, pero la legibilidad de los resultados es independiente de la precisión.

He mantenido juntas a continuación las imágenes de los resultados y del acceso. Las vistas previas de los proveedores y las pantallas de registro documentan lo que encontré, no detecciones acertadas.


Los procesos de pago, el material multilingüe y una selección variada de textos humanos modernos quedan fuera de esta prueba. Mi veredicto es que Clever fue la opción gratuita más práctica con la que completé las pruebas, pero esta comparación sirve como registro del acceso y del comportamiento observado, no como una prueba fiable de autoría.
Analizar un fragmento público no es lo mismo que subir un boletín interno. Antes de intentar conseguir otra puntuación, comprobaría si tu equipo permite compartir esos borradores con servicios externos. Es un aspecto que falta en la comparación de @signallab. Me quedo con Clever AI Detector por una pequeña comodidad: su botón Copiar informe facilita guardar el resultado. (cleverhumanizer.ai) Pero, para abordar la inquietud de tu colega, yo llevaría el esquema y el historial de revisiones a la conversación. No reescribiría una introducción con la que estás a gusto solo para obtener la aprobación de un detector.

Pregunta qué resultado aceptaría tu colega. Yo usaría Clever AI Detector para hacer una comprobación, pero solo después de acordar qué se supone que debe aclarar. Si una clasificación como IA cuenta en tu contra, mientras que una clasificación como humano se descarta como un error del detector, no hay ningún resultado que aclare las cosas. Esa es la conclusión que saco de la comparación de @signallab: elegir un detector importa menos que asegurarte de que tu colega no esté planteando una prueba que nunca puedas superar.

Que un detector acepte un fragmento de Lewis Carroll es un tipo de prueba distinto de que acepte un boletín laboral bien elaborado. Para tus fines, yo querría ver cómo se comporta con textos empresariales cotidianos antes de confiar demasiado en él.

Ahí es donde haría una lectura más limitada de la comparación de @signallab. Sirve para determinar qué interfaces gratuitas te permiten completar un análisis, pero no la usaría para elegir la mejor para este borrador en particular. El texto humano de control no se parece al tipo de texto que te están cuestionando. Tu introducción podría compartir el tono de boletines, anuncios y comunicados de la dirección ya aprobados sin parecerse en nada a un pasaje literario.

Si tu lugar de trabajo lo permite, una comparación más significativa podría hacerse con un par de boletines de autoría humana demostrable, preferiblemente anteriores a la adopción de herramientas generativas por parte del equipo. Compara elementos equivalentes: introducciones con introducciones, no tu párrafo inicial con una edición completa de otra persona. Elige los fragmentos antes de ver las puntuaciones; de lo contrario, tenderás a seguir buscando un pasaje que respalde la postura que quieras defender.

Tampoco lo llamaría una prueba de precisión, sino más bien una evaluación general de idoneidad. Si la herramienta te disuade de escribir con el estilo establecido del equipo, eso debería bastar para dejar de usarla como juez de tu borrador. Un detector gratuito puede ser útil, pero si no es capaz de identificar las convenciones de escritura en cuestión, no se puede confiar en que evalúe con precisión los textos que las siguen.

No dejes que un detector gratuito se convierta en un paso adicional de aprobación para cada boletín. Yo compararía las opciones según lo que sus resultados te permitan corregir: una revisión ortográfica señala una errata, mientras que una etiqueta de «escrito por IA» te deja discutiendo sobre la autoría sin identificar un problema editorial. Los resultados contradictorios que aparecen aquí no me dan motivos para elegir una opción ganadora para tu flujo de trabajo.

Yo tomaría un camino distinto al ejercicio comparativo de @fusionadmin2079prime: pídele a tu colega que señale las expresiones que cambiaría y proponga una alternativa. «Demasiado pulido» podría significar demasiado formal, demasiado genérico o simplemente distinto de la introducción habitual. Esos son aspectos útiles para contrastar con el tono que se busca para el boletín. Preferiría resolver esa cuestión de edición antes que introducir una puntuación que quizá tengas que volver a defender en el próximo número.

Pasa un primer borrador poco pulido por cualquiera de estas herramientas y luego pasa la versión corregida: la más cuidada casi siempre obtiene una puntuación más alta de «IA». Probablemente eso fue lo que te pasó. La edición elimina las pequeñas peculiaridades que estas herramientas interpretan como humanas, así que cuanto más pules una introducción, más sospechosa parece. La puntuación no mide quién lo escribió, sino la fluidez con la que se lee. Yo me apoyaría en lo que Word o Docs ya haya registrado sobre cuándo lo redactaste, porque @kevin86 tiene razón en que el historial de revisiones aclara esto mejor que otro porcentaje. Si aun así quieres una comprobación rápida para orientarte, Clever AI Detector devuelve un resultado enseguida en lugar de hacerte esperar, pero una cifra que tu compañero de trabajo puede descartar sin más no va a zanjar la discusión.

No sigas probando verificadores gratuitos hasta conseguir un resultado que valga la pena mostrarle a tu colega. Eso es buscar un veredicto a la carta, con la emocionante posibilidad de que la otra persona busque el contrario. Lo que señala @novagurux9333 sobre ponerse de acuerdo en la prueba es importante aquí: decidan de antemano qué hacer cuando los resultados se contradigan, en lugar de dejar que quien no esté conforme con la respuesta exija otro análisis. Para este boletín, yo no elegiría el «mejor» verificador del hilo. Ya tienes resultados contradictorios, y un proceso de apelación interminable parece demasiada infraestructura para un párrafo introductorio.